
Bauanleitung: KI an die Buchhaltungssoftware anbinden
Von Mag. Volker Schattel · Veröffentlicht am 19.08.2026 · Aktualisiert am 20.09.2026 · Stand: 08/2026
Dieser Artikel ist der technische Unterbau zum Praxisbericht „Autonome Buchhaltung”. Er beantwortet die Fragen, die dort offen bleiben mussten: Wie funktioniert die Anbindung technisch, welche Regeln machen sie sicher, was bedeutet das für Datenschutz und Betriebsprüfung – und was ändert sich, wenn Sie keine Einnahmen-Ausgaben-Rechnung führen, sondern doppelte Buchhaltung mit mehreren Beteiligten.
Er ist bewusst ausführlich. Sie können ihn Ihrer IT, Ihrem Steuerberater oder einem Dienstleister in die Hand geben – er enthält alles, was für eine fundierte Machbarkeitseinschätzung nötig ist. Stand aller Rechts- und Technikangaben: 08/2026.
Teil 1: Die Grundlagen
Warum scheitern klassische Buchhaltungs-Automatiken?
Die Automatisierungsversprechen der letzten zwanzig Jahre – Belegerkennung, Buchungsvorschläge, Bankregeln – automatisieren das Übertragen, nicht das Entscheiden. Eine Texterkennung liest „Rechnung, 238,80 Euro” zuverlässig; ob das ein Software-Abo (laufender Aufwand), ein geringwertiges Wirtschaftsgut (Sofortabschreibung) oder eine aktivierungspflichtige Anlage ist, entscheidet sie nach oberflächlichen Mustern – und liegt oft genug falsch. Wer die Vorschläge ungeprüft übernimmt, sammelt systematische Fehler; wer sie prüft, hat die Arbeit, die er sich sparen wollte.
Die Entscheidungsarbeit – Kontierung, Steuerlogik, Periodenzuordnung, Zahlungsabgleich über mehrere Konten – blieb bisher beim Menschen, weil kein System gleichzeitig den Beleg verstehen, den Kontext kennen (Kontenplan, Lieferantenhistorie, frühere Entscheidungen) und mit der Buchhaltungssoftware sprechen konnte. Genau diese Lücke schließt die KI-Anbindung.
Was ist MCP – und warum ändert es die Spielregeln?
MCP (Model Context Protocol) ist ein offener Standard, über den KI-Assistenten kontrolliert auf externe Systeme zugreifen: Datenbanken, Ablagen – und eben Buchhaltungssoftware. Das Prinzip: Ein kleines Verbindungsprogramm (ein „MCP-Server”, im Regelfall lokal auf einem Rechner im Unternehmen) stellt der KI einzelne, genau definierte Werkzeuge zur Verfügung – etwa „lies die Eingangsrechnungen der Woche” oder „lege diese freigegebene Rechnung an”. Die KI kann ausschließlich diese Werkzeuge nutzen. Was es als Werkzeug nicht gibt, kann sie nicht tun.
Das ist der entscheidende Unterschied zu einem „KI-Feature” im Buchhaltungsprogramm: Sie definieren die Werkzeuge und deren Grenzen selbst – welche Daten die KI liest, was sie schreiben darf, welche Bestätigungen nötig sind. Sie sind nicht darauf angewiesen, was der Softwarehersteller auf seiner Produkt-Roadmap hat, und Sie können jede Regel Ihres Unternehmens (Freigabegrenzen, Vier-Augen-Prinzip, Betragslimits) direkt in die Werkzeuge einbauen.
Welche Voraussetzungen muss Ihre Buchhaltungssoftware erfüllen?
Die ganze Architektur steht und fällt mit einer Frage: Hat Ihre Buchhaltungssoftware eine offene Programmierschnittstelle (API) – und bekommen Sie selbst Zugriff darauf? Konkret zu klären:
- Gibt es eine dokumentierte API für Belege, Buchungen, Stammdaten?
- Können Sie einen eigenen technischen Benutzer mit fein abgestuften Rechten anlegen (nur lesen / schreiben je Modul)?
- Liegt der Zugriff bei Ihnen – oder nur beim Steuerberater beziehungsweise Hersteller?
In der Praxis ist das der Punkt, an dem die meisten Projekte enden, bevor sie beginnen. Für Österreich kenne ich genau einen Anbieter, dessen Schnittstelle offen und vollständig genug ist, dass ein System wie das beschriebene darauf laufen kann: FreeFinance. Dort läuft unser Aufbau produktiv. Für Deutschland testen wir denselben Aufbau derzeit gegen DATEV, dessen Entwickler-Schnittstelle die nötigen Möglichkeiten grundsätzlich bietet – ob sie in der Praxis trägt, sagen wir, wenn der Test abgeschlossen ist. Bei den übrigen etablierten Systemen (BMD, Sage, Microsoft Business Central und andere) existieren APIs oder Partnerschnittstellen mit sehr unterschiedlicher Offenheit; die Frage ist dort nicht ob, sondern über welchen Weg und mit wessen Freigabe.
Diese Klärung ist der erste Arbeitsschritt jedes Projekts, noch vor jeder KI-Diskussion. Und sie hat eine unbequeme Kehrseite: Wenn Ihre Software Ihnen den Zugriff auf Ihre eigenen Daten nicht gibt, ist das eine Aussage über die Software.
Was läuft da eigentlich im Hintergrund – und was nicht?
Damit keine falschen Erwartungen entstehen: Hier läuft kein Chatbot, in den man Belege hineinwirft. Die Bestandteile sind:
- Ein aktuelles Spitzenmodell – kein „irgendeine KI”, sondern eines der jeweils leistungsfähigsten verfügbaren Modelle. Bei Buchhaltungslogik ist der Unterschied zwischen Modellgenerationen nicht kosmetisch.
- Ein Harness. So heißt der Rahmen, in dem das Modell arbeitet – vereinfacht gesagt das, was die Claude- oder ChatGPT-App im Kleinen sind: die Schicht, die dem Modell Werkzeuge gibt, Arbeitsschritte steuert und Ergebnisse zurückführt. Nur eben nicht für Chat gebaut, sondern für einen Arbeitsablauf mit Schreibrechten. Es gibt dafür fertige Open-Source-Harnesses; man muss das nicht selbst erfinden.
- Ein Wissensspeicher („Second Brain”): Alles, was der Betrieb über Lieferanten, Kontenlogik, Sonderfälle und frühere Entscheidungen weiß, liegt strukturiert vor und wird bei jeder Verarbeitung mitgegeben. Das ist der Unterschied zwischen einem Modell, das raten muss, und einem, das den Betrieb kennt.
Wer nur die App installiert, bekommt einen Assistenten. Wer diese drei Teile zusammenbaut, bekommt einen Prozess.
Teil 2: Der Bauplan
Wie muss die Belegablage aussehen, bevor die KI ins Spiel kommt?
Die unbequeme Wahrheit zuerst: Die KI ist nur so gut wie die Ablage, auf die sie schaut. Vier Regeln, die sich bewährt haben – und die sich auch ohne jede KI sofort lohnen:
- Eine Quelle der Wahrheit. Alle Belege eines Zeitraums an einem Ort (Cloud-Ordner, nach Quartalen oder Monaten), nicht verteilt über Postfächer, Downloads und Papierstapel.
- Sprechende Dateinamen mit Datum – und zwar dem für Ihre Gewinnermittlung maßgeblichen Datum. Bei Einnahmen-Ausgaben-Rechnung ist das das Zahlungsdatum, nicht das Rechnungsdatum; bei Bilanzierung sind beide Daten relevant und müssen erfasst sein.
- Bankdaten aus einer Quelle lesen, nie kopieren. Am besten gar nicht als Datei: Hängt die Buchhaltungssoftware über die PSD2-Schnittstelle direkt am Geschäftskonto (bei FreeFinance heißt das schlicht Bankanbindung), holt sie die Kontobewegungen täglich selbst ab – und die KI liest sie über dieselbe API mit. Wo das nicht geht, liegen Kontoauszüge, Kartenabrechnungen und Zahlungsdienstleister-Exporte an je einem festen Ort und werden von dort gelesen; Kopien in Arbeitsordnern erzeugen Versionskonflikte.
- Gepflegte Stammdaten als eigene Dateien: Lieferantenliste mit Standard-Kontierung und Steuerbehandlung, Liste der Dauerabbuchungen, klare Abgrenzung privater Zahlungen (relevant bei Einzelunternehmen).
Im größeren Unternehmen heißt dieser Abschnitt nicht „Ordnerstruktur”, sondern Rechnungseingangs-Workflow und Stammdatenpflege – dasselbe Problem mit Zuständigkeiten. Wer hier Wildwuchs hat, braucht zuerst Prozessarbeit, dann KI.
Wie funktioniert das Stufenmodell A–D?
Der Kern der Bauanleitung. Das System wird in vier Stufen aufgebaut, und jede Stufe muss sich beweisen, bevor die nächste freigeschaltet wird:
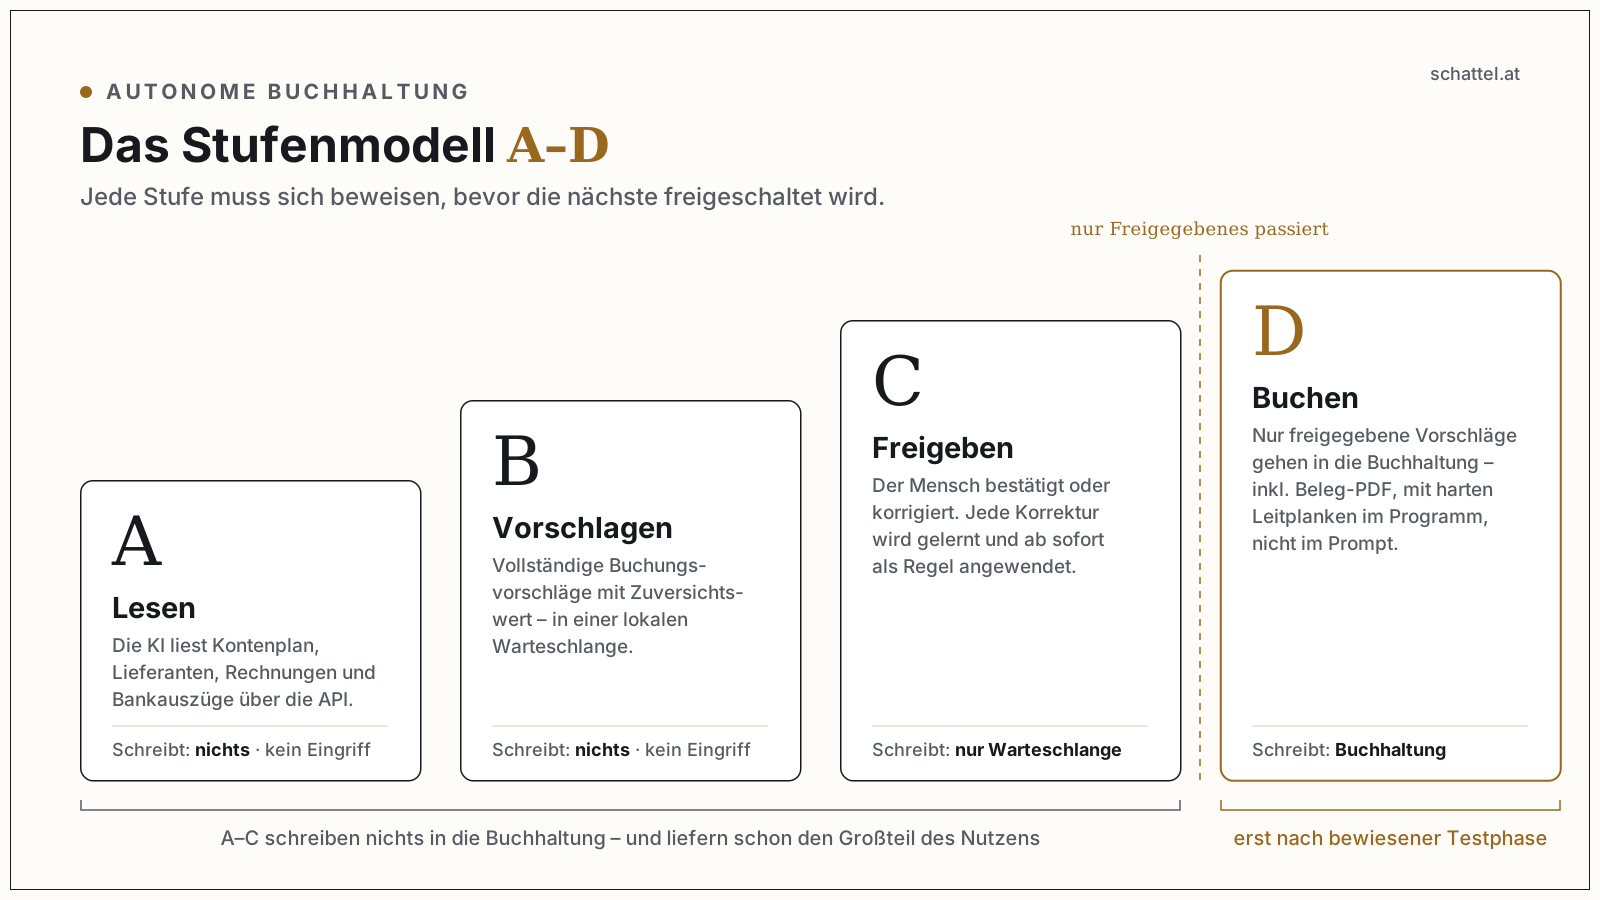
| Stufe | Was passiert | Was geschrieben wird | Eingriff in die Buchhaltung |
|---|---|---|---|
| A – Lesen | KI liest Kontenplan, Lieferanten, Rechnungen, Bankauszüge über die API | nichts | keiner |
| B – Vorschlagen | KI erstellt vollständige Buchungsvorschläge (Lieferant, Konto, Steuer, Datum, Betrag, Zuversichtswert) in einer lokalen Warteschlange | nichts in der Buchhaltung | keiner |
| C – Freigeben | Mensch prüft die Vorschläge, sagt „passt” oder korrigiert; jede Korrektur wird gelernt | nur die lokale Warteschlange | keiner |
| D – Buchen | Ausschließlich freigegebene Vorschläge werden in die Buchhaltungssoftware geschrieben, inklusive Beleg-PDF | Buchhaltung, mit Leitplanken | kontrolliert |
Zwei Konsequenzen dieses Aufbaus werden regelmäßig unterschätzt.
Erstens: Die Stufen A bis C sind bereits das halbe Produkt. Eine KI, die alle Belege liest, sauber vorkontiert und Unstimmigkeiten meldet, spart den Großteil der Arbeit – auch wenn ein Mensch die Buchung noch selbst auslöst. Wer unsicher ist, bleibt dauerhaft auf Stufe C und hat trotzdem gewonnen.
Zweitens: Wer bei D anfängt, scheitert. Ohne die Lernphase der Stufen B und C bucht die KI mit der Trefferquote des ersten Tages – und das Vertrauen, das ein Fehler in der echten Buchhaltung zerstört, gewinnt man nicht zurück. Die Testphase auf den Stufen ohne Buchungszugriff ist keine Vorsicht, sie ist der Bauplan.
Welche Leitplanken verhindern Fehlbuchungen?
Stufe D wird erst durch Regeln vertretbar, die nicht in einem Prompt stehen, sondern hart im Verbindungsprogramm einprogrammiert sind. Die KI kann sie nicht umgehen, weil die Werkzeuge sie erzwingen:
- Kein Freitext-Buchen. Das Buchungswerkzeug akzeptiert ausschließlich Vorschläge aus der Warteschlange mit Status „freigegeben”. Ein direkter Buchungsbefehl existiert nicht.
- Duplikatsprüfung vor jedem Schreiben. Vor jedem Anlegen wird per Rechnungsnummer, Lieferant und Zeitraum geprüft, ob die Rechnung schon existiert – wichtig, weil viele APIs einen doppelt gesendeten Befehl klaglos doppelt ausführen.
- Zahlung immer als getrennter zweiter Schritt. Eine Rechnung wird nie gleichzeitig angelegt und als bezahlt markiert. Solange ein Vorschlag nicht verbucht ist, lässt er sich korrigieren oder verwerfen; Verbuchtes wird storniert, nicht gelöscht – Original und Änderung bleiben im Protokoll (§ 131 BAO). Der Rückweg bleibt bei jedem Schritt offen, nur nicht spurlos.
- Betragsgrenze. Belege über einer definierten Schwelle (bei uns 1.000 Euro) laufen nie im Stapel durch, sondern immer einzeln zur Freigabe.
- Plausibilisierung vor dem Schreiben. Zeilensummen gegen Belegbetrag, Steuerbetrag gegen Steuersatz; bei Abweichung geht der Beleg zurück in die Warteschlange statt in die Buchhaltung.
- Lückenloses Protokoll. Jede Schreiboperation wird vor und nach der Ausführung protokolliert. Bricht ein mehrstufiger Vorgang ab (Rechnung angelegt, PDF-Anhang fehlt noch), erkennt das System das beim nächsten Lauf und repariert, statt neu anzulegen.
- Die KI rechnet nicht. Die wichtigste Regel zum Schluss: Beträge, Summen und Steuersätze stammen aus Belegen und Stammdaten, nicht aus dem Sprachmodell. Überall dort, wo gerechnet wird – Rechnungsbeträge, Prüfsummen – arbeitet deterministischer Code. Die KI klassifiziert, ordnet zu und orchestriert; sie ist nie die Quelle einer Zahl.
Wie lernt das System dazu?
Neben der Warteschlange führt das System einen lokalen Lernspeicher mit drei Bestandteilen: Lieferanten-Zuordnungen (welcher Belegtext gehört zu welchem Lieferanten im Stamm – löst nebenbei das Dublettenproblem), Kontierungsregeln (Lieferant plus gegebenenfalls Stichwort ergibt Konto und Steuerbehandlung) und ein Korrektur-Journal: Jede Freigabe und jede Korrektur des Menschen wird mit Vorher und Nachher festgehalten. Korrekturen erhöhen die Priorität einer Regel, wiederholte Bestätigungen den Zuversichtswert.
Wie das konkret aussieht: Ein neuer Anbieter taucht zum ersten Mal auf. Das System kennt ihn nicht, ordnet ihn keinem Muster zu und fragt nach – welcher Lieferant, welches Konto, welche Steuerbehandlung? Die Antwort wird nicht nur für diesen Beleg verwendet, sondern als Regel abgelegt. Bei der nächsten Rechnung desselben Anbieters kommt keine Frage mehr, sondern ein fertiger Vorschlag mit hohem Zuversichtswert, der im Stapel mitläuft und nur noch bestätigt wird. Dasselbe passiert bei jeder Korrektur: Aus „nicht Fremdleistung, sondern Lizenzaufwand” wird eine Regel, die ab sofort greift.
Der Effekt ist der eigentliche Zinseszins des Systems: Mit jedem Durchlauf laufen mehr Belege oberhalb der Zuversichtsschwelle im Stapel durch, die Einzelfälle werden weniger. Die Freigabearbeit des Menschen ist damit kein Kontrollaufwand, der ewig gleich bleibt – sie ist eine Investition, die sich abbaut.
Wie kommen die Belege überhaupt herein?
Der Teil, der im Alltag am meisten Handgriffe spart und am wenigsten spektakulär klingt: Eingangsrechnungen laufen über ein eigenes Rechnungs-Postfach. Was dort ankommt und dem gewohnten Muster entspricht, wird automatisch zum Buchungsvorschlag – ohne dass jemand die Mail öffnet, den Anhang speichert, die Datei umbenennt oder sie irgendwo hochlädt. Der Mensch sieht am Ende eine Liste und bestätigt den Stapel.
Vom Ergebnis her ist das ein automatisierter Workflow, wie man ihn von Make, Zapier oder n8n kennt. Der Unterschied liegt darin, was in der Mitte steht: kein Regelbaum, der bei jedem unerwarteten Belegformat abbricht, sondern ein System, das den Beleg liest und versteht. Genau deshalb funktioniert es auch bei den Lieferanten, für die niemand je eine Regel gebaut hätte.
Wie automatisieren Sie die Ausgangsrechnungen?
Die vergessene Hälfte der Buchhaltung. Für wiederkehrende Leistungen (Betreuungspauschalen, Abos, Wartungsverträge) läuft ein monatlicher Lauf: Für jeden aktiven Kunden wird geprüft, ob für die Periode schon eine Rechnung existiert (Duplikatsschutz je Kunde und Monat), dann wird der Entwurf erstellt – mit Preisen aus den hinterlegten Artikeln, Konto und Steuerlogik aus dem Kundenstamm, alles deterministisch. Der Mensch gibt den Stapel frei; danach werden die Rechnungen finalisiert, als PDF archiviert und für den Versand vorbereitet. Prüfsummen und ein wiederanlauffähiges Journal sorgen dafür, dass ein abgebrochener Lauf beim nächsten Start sauber weitermacht.
Je regelmäßiger Ihre Fakturierung, desto größer der Hebel. Dazu kommt der Zeitfaktor E-Rechnung:
- Deutschland: Seit 01.01.2025 müssen Unternehmen E-Rechnungen empfangen können. Die Pflicht zur Ausstellung gilt für Umsätze zwischen zwei in Deutschland ansässigen Unternehmen – ein österreichischer Betrieb, der deutschen Kunden Rechnungen stellt, ist nicht erfasst – und greift gestaffelt: ab 01.01.2027 für Unternehmen mit einem Vorjahresumsatz über 800.000 Euro, ab 01.01.2028 für alle übrigen; EDI-Verfahren haben ebenfalls bis Ende 2027 Zeit. Ausgenommen bleiben Kleinunternehmer nach § 19 UStG, Kleinbetragsrechnungen bis 250 Euro, Fahrausweise und bestimmte steuerfreie Umsätze. Rechtsgrundlage ist § 14 UStG in der Fassung des Wachstumschancengesetzes; das Format muss der Norm EN 16931 entsprechen (XRechnung, ZUGFeRD ab Profil Comfort).
- Österreich: keine allgemeine B2B-Pflicht. Verpflichtend sind strukturierte Rechnungen nur gegenüber dem Bund, seit 2014 über erechnung.gv.at. Für innergemeinschaftliche B2B-Umsätze kommt die Pflicht über die EU-Richtlinie ViDA ((EU) 2025/516) ab 01.07.2030; für reine Inlandsgeschäfte entscheidet Österreich selbst, ein Zeitplan liegt bislang nicht vor.
Wer seine Rechnungsdaten jetzt sauber strukturiert, erledigt die Pflichtübung gleich mit. (Stand: 08/2026.)
Was fand die KI beim Systemtest im Altbestand?
Bevor das System schreiben durfte, musste es prüfen können – der komplette Altbestand mehrerer Jahre wurde kontrolliert. Die Funde sind ein Lehrstück darüber, wo klassische Automatik systematisch danebenliegt:
- Software auf dem falschen Konto. Die eingebaute Texterkennung hatte Software-Anschaffungen des Vorjahres dem Anlagevermögen zugeordnet, obwohl sie dort nicht hingehörten. Ergebniswirksam war das nicht – die Abschreibung als geringwertiges Wirtschaftsgut war ordnungsgemäß erfolgt. Der Schaden war ein anderer: ein aufgeblähtes Anlagenverzeichnis und eine Kontierung, die bei jeder späteren Auswertung in die Irre führt.
- Die OSS-Vorsteuerfalle. Ausländische Digitalanbieter rechnen Betriebe, die keine UID hinterlegt haben, wie Privatkunden ab: mit österreichischer beziehungsweise deutscher Umsatzsteuer, abgeführt über den One-Stop-Shop. Für eine B2B-Leistung wäre aber Reverse Charge richtig – die ausgewiesene Steuer ist damit zu Unrecht ausgewiesen und keine abziehbare Vorsteuer. Ein Hinweis darauf: Die Rechnung nennt keine inländische UID des Anbieters, und die eigene UID fehlt – ob wirklich falsch abgerechnet wurde, entscheiden Leistung, Leistungsort und Unternehmerstatus, nicht das Rechnungsformular. Die Konsequenz ist dreifach: Vorsteuerkorrektur, Reverse Charge nachträglich erfassen (Steuerschuld und – bei vollem Abzugsrecht – Vorsteuer in derselben Erklärung) und beim Anbieter die eigene UID hinterlegen, damit künftig Netto-Rechnungen kommen.
- Kleinvieh mit System: doppelt erfasste Belege (Abos haben systembedingt identische Beträge – Duplikate erkennt man an Rechnungsnummer plus Lieferant, nicht am Betrag), mehrfach angelegte Lieferanten im Stamm, eine Zahlung im falschen Wirtschaftsjahr.
Diese Fehlerbilder sind nicht exotisch – sie entstehen überall dort, wo Vorschlagsautomatik auf Zeitdruck trifft. Eine KI-Prüfung des Bestands ist deshalb auch als eigenständige Maßnahme sinnvoll, ganz ohne Buchungsautomatisierung.
Und sie hat einen zweiten Nutzen, den ich vorher unterschätzt hatte. Dass saubere Daten und Prozesse die Voraussetzung für jede Automatisierung sind, ist bekannt und richtig. Weniger beachtet wird, was die Bereinigung mit den Beteiligten macht: Ein System, das im eigenen Altbestand Fehler findet, die man selbst jahrelang übersehen hat, gewinnt Vertrauen schneller als jede Demo. Vorher diskutiert man darüber, ob eine KI buchen darf. Nachher diskutiert man darüber, was sie als Nächstes prüfen soll. Deshalb steht die Einzelprüfung des Altbestands bei uns nicht als Pflichtübung am Anfang, sondern als bewusster Schritt – sie ist die Testphase und die Vertrauensbildung in einem.
Für die Stammdaten gilt dasselbe im Kleinen: Dublette Lieferanten, uneinheitliche Schreibweisen, verwaiste Konten. Diese Art von Datenbereinigung ist eine unserer Kernaufgaben – wie das in größerem Maßstab aussieht, zeigen die Beispiele in unserer Projektgalerie.
Teil 3: Übertragung auf Ihr Unternehmen
Was ändert sich bei doppelter Buchhaltung?
Das beschriebene System läuft in einer Einnahmen-Ausgaben-Rechnung. Dieser Unterschied ist allerdings kleiner, als er wirkt: Die Software führt im Hintergrund ohnehin eine doppelte Buchhaltung, die Einnahmen-Ausgaben-Rechnung ist nur die Auswertungssicht darauf. Für die Umstellung müsste im Kern eine Regel getauscht werden – statt des Zahlungszeitpunkts entscheidet die wirtschaftliche Zuordnung: Rechnungsdatum, Leistungszeitraum und Zahlungsdatum sind drei getrennte Felder, nicht eines. Alles darüber bleibt, wie es ist.
Für Bilanzierer gilt deshalb, ehrlich sortiert:
Unverändert übertragbar: Belegerkennung und -extraktion, Lieferanten-Zuordnung, Duplikatsprüfung, das Stufenmodell, sämtliche Leitplanken, das Lernsystem, der Ausgangsrechnungslauf.
Anders, aber lösbar: Periodenabgrenzung statt Zufluss-Abfluss – Rechnungs-, Leistungs- und Zahlungsdatum sind drei getrennte Ereignisse mit eigener Logik. Personenkonten und Offene-Posten-Verwaltung kommen dazu; der Zahlungsabgleich wird dadurch strukturierter, nicht schwerer. Kostenstellen und Kostenträger sind für die KI schlicht eine weitere Klassifikationsdimension – sie braucht dafür Regeln, keine Wunder. Anlagenbuchhaltung mit AfA-Läufen bleibt Sache der Buchhaltungssoftware; die KI liefert die korrekte Zuordnung zu.
Wirklich anspruchsvoller: Freigabeketten über mehrere Personen – die KI füllt das bestehende Vier-Augen-Prinzip vor, ersetzt aber keine Zuständigkeitsordnung; die will vorher geklärt sein. Mehr Belegquellen und Vorsysteme (ERP, Warenwirtschaft, Reisekosten) bedeuten mehr Schnittstellen im Erstprojekt. Intercompany-Verrechnung und Konsolidierung liegen außerhalb dessen, was dieses Konzept abdeckt.
Zur Größenordnung: In meinem Betrieb ersetzt das System rund zwei Arbeitstage pro Quartal. Bei einem Mittelständler mit 800 Eingangsrechnungen im Monat entspricht die gleiche Mechanik rechnerisch einem erheblichen Teil einer Stelle – das ist eine Hochrechnung, keine Messung, aber der Hebel wächst linear mit dem Belegvolumen, während der Aufbauaufwand weitgehend fix ist.
Wie steht es um Datenschutz und Datenhoheit?
Die Architekturentscheidung, die alles Weitere bestimmt: Das Verbindungsprogramm läuft lokal im Unternehmen. Kein Cloud-Zwischendienst, keine Automatisierungsplattform, über die Buchhaltungsdaten laufen, kein Datenabfluss an Dritte jenseits der ohnehin genutzten Systeme. Auch der Lernspeicher – Lieferantenregeln, Kontierungslogik, Korrekturhistorie – liegt in einer lokalen Datei. Wechseln Sie den KI-Anbieter, nehmen Sie Ihr gelerntes Wissen mit.
Wer auch das nicht will, hat einen zweiten Weg: Statt eines Anbietermodells ein Open-Weight-Modell in einem EU-Hosting betreiben. Die frei verfügbaren Modelle sind inzwischen gut genug für Klassifikations- und Zuordnungsaufgaben dieser Art, und mit einem europäischen Hoster verlassen die Belegdaten den EU-Raum nicht. Dasselbe gilt für den Rahmen drumherum: Es gibt Open-Source-Harnesses – gemeint ist die Schicht, die dem Modell Werkzeuge gibt und die Arbeitsschritte steuert, im Prinzip das, was die Claude- oder ChatGPT-App tut –, sodass die gesamte Kette aus Modell, Harness und Verbindungsprogramm unter eigener Kontrolle laufen kann. Der Preis dafür ist etwas Qualität an den schwierigen Rändern und mehr Betriebsaufwand; die Architektur ändert sich nicht.
Was ein Anbietermodell dagegen sieht, sind die Inhalte der jeweiligen Verarbeitung – Belegdaten, Kontexte, Vorschläge. Das ist datenschutzrechtlich eine Auftragsverarbeitung wie bei jedem Cloud-Dienst: Sie brauchen einen Auftragsverarbeitungsvertrag, eine Regelung zur Nichtverwendung Ihrer Daten für Modelltraining (bei Geschäftskonditionen der großen Anbieter Standard) und einen Eintrag im Verarbeitungsverzeichnis. Personenbezug ist in Eingangsrechnungen meist gering (Firmendaten), bei Ausgangsrechnungen und erst recht bei Lohndaten entsprechend höher – der Zuschnitt der Werkzeuge bestimmt, was die KI überhaupt zu sehen bekommt. Genau dafür ist die selbst definierte Schnittstelle da.
Ist das prüfsicher? Verfahrensdokumentation und Nachvollziehbarkeit
Wer KI buchen lässt, muss einem Prüfer erklären können, wie gebucht wird. Die Anforderungen sind nicht neu: In Österreich verlangen die §§ 131 f. Bundesabgabenordnung nachvollziehbare, vollständige und richtige Aufzeichnungen; in Deutschland konkretisieren die GoBD die Anforderungen an IT-gestützte Buchführung inklusive Verfahrensdokumentation.
Das beschriebene System ist dafür besser aufgestellt als manuelle Arbeit, nicht schlechter: Jede Schreiboperation ist mit Zeitstempel, Anfrage und Antwort protokolliert, jeder Buchungsvorschlag trägt seine Herkunft (Regel, Zuversichtswert, freigebende Person), jede Korrektur ist im Journal dokumentiert. Die Verfahrensdokumentation – welcher Schritt läuft automatisch, wo prüft ein Mensch, welche Leitplanken gelten – schreibt sich daraus fast von selbst; erstellt werden muss sie trotzdem. Ab einer gewissen Unternehmensgröße kommen internes Kontrollsystem, Funktionstrennung und gegebenenfalls die Mitbestimmung dazu – alles lösbar, aber vor dem Produktivbetrieb zu klären, nicht danach. (Stand: 08/2026.)
Wo liegen die Grenzen?
Vier Dinge, die dieser Ansatz nicht leistet – damit Sie mit realistischen Erwartungen planen:
Der letzte Schritt des Bankabgleichs – das Abhaken einer zugeordneten Bewegung in der Oberfläche – bleibt je nach Software Handarbeit. Die eigentliche Zuordnungsarbeit fällt weg, sobald das Konto über PSD2 angebunden ist und die KI die Bewegungen mitliest; ohne Anbindung bleibt sie mühsam. Schnittstellen ändern sich – wer auf eine Beta-API baut, braucht jemanden, der bei Änderungen nachzieht. Der Altbestand muss einmal bereinigt werden, bevor das System produktiv lernt, sonst lernt es die Altfehler als Regel. Und der Aufbau ist ein Projekt: mehrere Wochen vom ersten Lesezugriff bis zur ersten freigegebenen Buchung, mit Testphase. Wer ein Wochenend-Setup erwartet, wird enttäuscht; wer einen Prozessumbau mit dauerhafter Rendite erwartet, nicht.
Teil 4: Ihr Einstieg
Ist Ihr Unternehmen bereit? Der Selbst-Check
Acht Fragen, ehrlich beantwortet:
- Hat Ihre Buchhaltungssoftware eine offene API – und haben Sie selbst Zugriff darauf?
- Liegen Ihre Belege an einem Ort, oder verteilt über Postfächer und Papier?
- Sind Ihre Lieferanten-Stammdaten gepflegt (keine Dubletten, Standard-Kontierung bekannt)?
- Gibt es einen definierten Freigabeprozess für Rechnungen (und sei es „ich selbst”)?
- Ist Ihr Belegvolumen groß genug, dass sich Aufbauaufwand lohnt (Faustregel: ab etwa 50 Belegen im Monat wird es interessant, darunter ist Stufe A–C trotzdem oft sinnvoll)?
- Gibt es intern eine Person, die das System betreuen kann oder will?
- Existiert eine Verfahrensdokumentation Ihrer heutigen Buchhaltungsprozesse?
- Hängt Ihr Geschäftskonto bereits an der Buchhaltungssoftware (PSD2 oder vergleichbar), oder werden Auszüge noch als Datei importiert?
Sechs bis acht Mal Ja: Sie sind bereit für einen Piloten. Drei bis fünf: erst Fundament (Ablage, Stammdaten, API-Klärung), dann KI. Unter drei: Das Automatisierungsthema ist bei Ihnen aktuell ein Prozessthema – auch das ist eine wertvolle Erkenntnis.
Wie fangen Sie an?
Der bewährte Weg in fünf Schritten: Ablage und Stammdaten ordnen. API-Zugang klären und einen rein lesenden technischen Benutzer einrichten. Die KI zwanzig echte Belege vorkontieren lassen und die Trefferquote messen. Zwei bis drei Durchläufe auf den Stufen B und C, bis die Quote trägt. Erst dann über das Buchen reden – als Pilot mit festem Rahmen und definiertem Ende.
Wenn Sie das strukturiert angehen wollen – mit Ihrer Software, Ihrem Volumen, Ihren Prozessen: Genau dafür gibt es unser Erstgespräch. Danach wissen Sie, ob und wo sich der Einstieg bei Ihnen lohnt, und was ein Pilot kosten würde. Entscheiden können Sie dann in Ruhe.
Volker Schattel führt die Unternehmensberatung Schattel und deren Payroll-Marke LohnLotsen. Das beschriebene System läuft produktiv in der eigenen Buchhaltung und wurde auf einen weiteren Betrieb übertragen. Rechtsangaben Stand 08/2026, geprüft am 19.08.2026: E-Rechnung DE – Empfangspflicht seit 01.01.2025, Ausstellungspflicht gestaffelt 2027/2028, § 14 UStG; AT – B2G über erechnung.gv.at, B2B innergemeinschaftlich ab 01.07.2030 über ViDA ((EU) 2025/516); Aufzeichnungspflichten §§ 131 f. BAO bzw. GoBD. Alle Angaben ohne Gewähr, sie ersetzen keine steuerliche Beratung im Einzelfall.
Über den Autor
Mag. Volker Schattel führt Schattel – Unternehmensberatung in Sistrans bei Innsbruck: 20 Jahre Praxis in HR, Controlling und Restrukturierung, kombiniert mit konsequentem KI-Einsatz. Er übernimmt Führungs- und Umsetzungsaufgaben in KMU im DACH-Raum – remote, dokumentiert, mit Systemen, die danach allein weiterlaufen.
Ähnliche Aufgabe im eigenen Betrieb?
Erstgespräch – kostenlos, remote, 30 Minuten. Sie schildern die Lage, wir sagen ehrlich, ob und wie wir helfen können.
Termin buchen